Kendi ürünüm · iOS
 SpeakTable
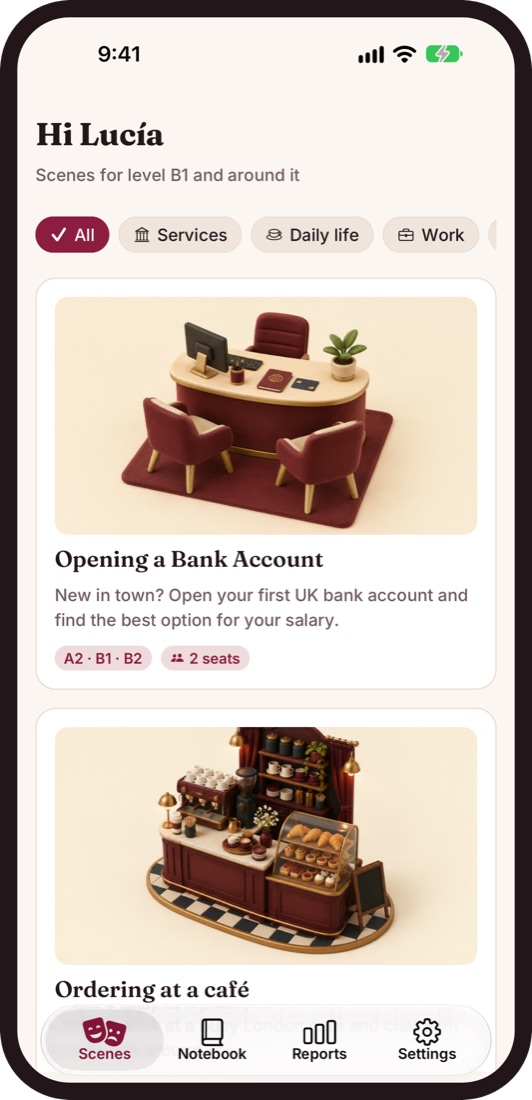
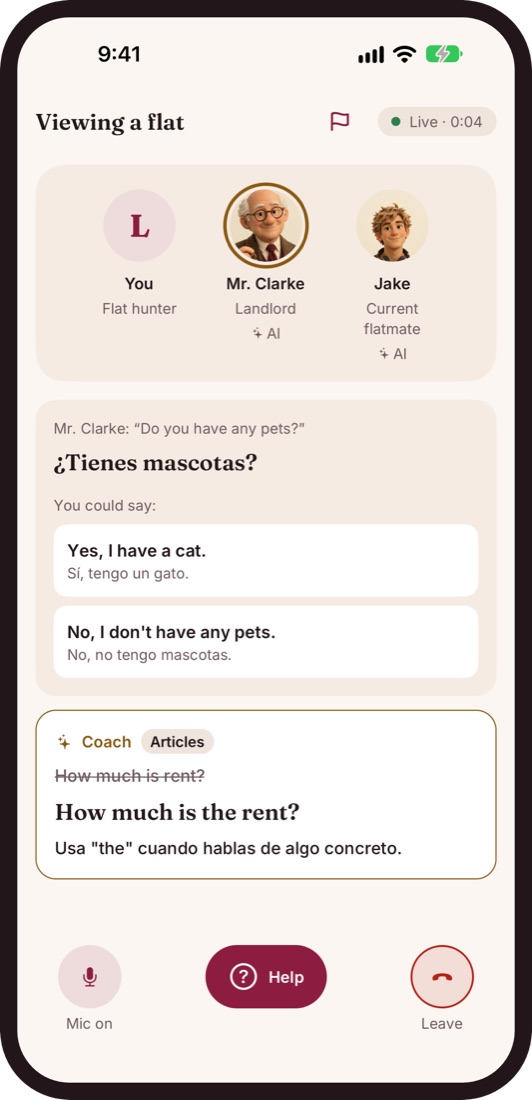
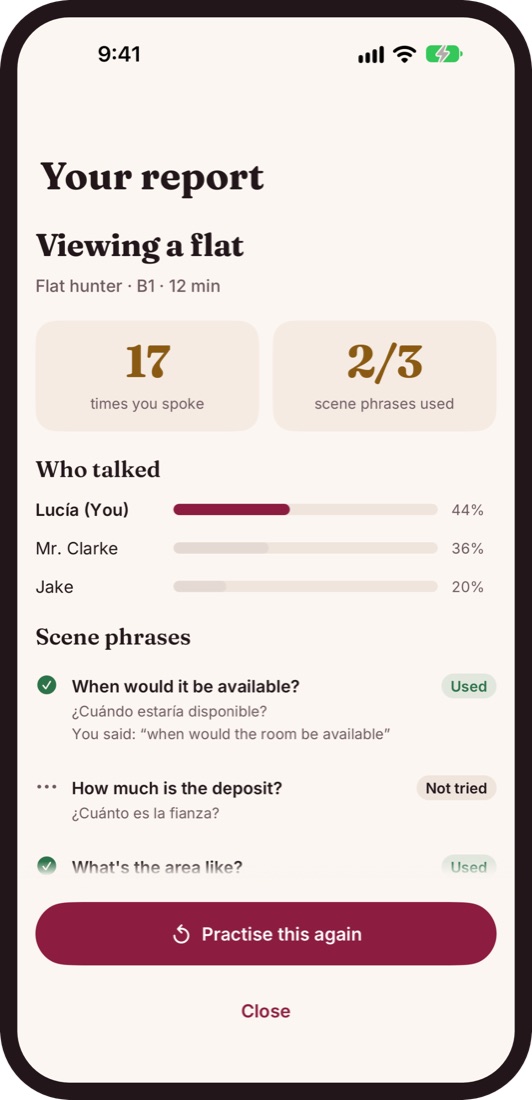
Dil pratiği için canlı, sesli rol yapma odaları. Gerçek insanlar ve yapay zekâ personaları aynı sahneyi paylaşıyor; özel bir koç her öğrenciye düzeltmesini fısıldıyor.
- Rol
- Kurucu ve baş mühendis — agent’lar, API, mobil, altyapı
- Yıl
- 2026
- Durum
- App Store incelemesinde
- Bağlantılar
- speaktable.com ↗
- 1,14 sn
- ses hattı p50, söz bitişi → ilk cevap
- ≈ 0,50 $
- 15 dakikalık oturumun model maliyeti
- 18
- LLM lint + prova hattından geçen senaryo
- 4
- arayüz dili, Arapça (RTL) dahil
Problem
Bire bir yapay zekâ konuşma partneri artık her yerde. Yalnız insanlardan oluşan pratik grupları da var. İkisinin kesişimi — insanlarla pratik yaparken sahneyi yapay zekânın yönetmesi ve seni özelden koçlaması — neredeyse boştu. Ürün tam olarak bu.
Bir odada en fazla dört koltuk var. Her koltukta ya insan ya agent oturuyor. “1 insan + 3 agent” ile “3 insan + 1 agent” aynı motorun farklı oturma düzeni. İki dakika içinde kimse gelmezse boş koltuklar personalarla dolar ve sahne başlar.
Neden tek bir speech-to-speech model değil
Speech-to-speech modeller kulağa harika gelir ama bir ses girer, bir ses çıkar diye tasarlanmıştır. Bir odada kimliği bilinen birden fazla insan, farklı seslerle birden fazla persona, sıranın kimde olduğuna karar veren bir mekanizma ve özel düzeltmeler için bir yan kanal gerekir. Bu yüzden ses yolu kademeli bir hat: STT → yönetmen → LLM → TTS. Her katman bir arayüzün arkasında, dil başına değiştirilebilir.
- Oda: LiveKit. Her katılımcı kendi ses kanalıyla geliyor, konuşmacı kimliği bedava — diarization yok.
- Yönetmen: büyük kısmı deterministik kod. Söz dağıtır, sessiz kalanı konuşmaya çeker, sessizliği kırar, fazı ilerletir, söz kesmeyi yönetir. Personalar kendi kafasına göre konuşmaz.
- Personalar: rol, senaryo ve öğrencinin seviyesine göre bir LLM promptu.
- Koç: dökümü sıcak yolun dışında okur, satır başına en fazla bir önemli düzeltmeyi yalnız o öğrencinin ekranına gönderir. Kimse odanın önünde düzeltilmez.
Prompt rica eder, kod garanti eder. Söz sırası, cevap uzunluğu, faz süreleri, günlük limit ve moderasyon kodda.
Tahmin değil, ölçüm
En riskli kalem gecikmeydi, ilk o ölçüldü. Kullanıcı sözünü net bitirdikten sonra hat p50 1,14 sn’de cevap veriyor; A1–A2 öğrenciler için seviyeye göre sabır eklendiğinden uçtan uca medyan bilerek daha uzun. 15 dakikalık bir oturumun model maliyeti yaklaşık 0,50 $, en büyük pay TTS’te. Abonelik fiyatını bu iki sayı belirledi.
Elle yazılmış sahneler yerine içerik hattı
Senaryolar veri: roller, fazlar, ön bilgi soruları ve CEFR seviyesine göre hedef kalıplar içeren YAML. Kataloğu ölçeklemek için üç CLI aracı var: scenario-gen taslak üretir, scenario-lint sözleşmeyi doğrular, scenario-rehearse simüle bir öğrenci ve LLM hakemle sahneyi baştan sona oynatır. Üçünden de — ve bir insandan — geçen sahne yayına girer.
Yayına almak
Prisma ve Postgres’li NestJS API, Redis tabanlı eşleştirme, kendi API’mizde doğrulanan Apple/Google girişi, RevenueCat abonelikleri, iki katmanlı moderasyon filtresi; hepsi Hetzner’de Caddy arkasında, kendi sunucumuzda. Expo uygulaması Türkçe, İngilizce, Arapça ve Almanca. App Review başlı başına bir projeydi: arka plan ses modu, yapay zekâ veri açıklaması ve rıza akışı baştan tasarlanıp belgelendi.